Mostrar código
# las cuentas están en iii-funciones.R
source(here::here("2026/11/mrp-multiencuesta/iii-funciones.R"))En la parte (I) construimos las bases, unimos microdatos y con raking creamos una tabla de postestratificación con la distribución conjunta en la población. En la parte (II) ajustamos un MRP (Gelman and Little 1997; Park et al. 2004) para estimar el voto y repartir escaños por provincia. También teníamos un modelo de participación, aunque los dos iban por separado.
Es decir, el modelo multinivel estimaba el voto según perfiles (edad, sexo, provincia, nivel de estudios, recuerdo de voto), y luego con el modelo de participación estimábamos qué perfiles tenían más probabilidad de estar seguros de ir a votar. Más tarde se ajustaba la participación nacional, para que coincidiera con la que hubo en 2023. Eso movía la participación de cada perfil.
Un ejemplo. Las mujeres de 65 años o más, con estudios bajos, de Valencia, que se abstuvieron el 23-J, dicen “10, seguro que voto” en un 29,9 %. Al ajustar la participación de España al 70,4 %, su participación sube al 44,2 %. No todos los perfiles suben lo mismo: los hombres de 45 a 54 años, con estudios altos, de Madrid, que votaron al PP, pasan del 79,5 % al 87,8 %.
Pero esto tenía un problema: al aumentar la participación en una celda, suponíamos que la gente de esa celda seguiría votando como la media estimada de su celda. Es decir, que los nuevos votantes votan igual que los que ya iban a votar.
¿Y si no es así?
# las cuentas están en iii-funciones.R
source(here::here("2026/11/mrp-multiencuesta/iii-funciones.R"))En las encuestas se pregunta cómo de seguro está uno de ir a votar, de 0 a 10. Voy a llamar seguros a los que dicen 10 y no seguros, o dudosos, al resto.
enc <- leer_encuestas()
muestra <- muestra_seg(enc) # seguro: dice 10
count(muestra, seg)
#> # A tibble: 2 × 2
#>   seg           n
#>   <chr>     <int>
#> 1 no_seguro  5388
#> 2 seguro    17974
Vamos a ver si votan igual. Un detalle: a partir de ahora voy a usar el voto más simpatía, también para el modelo de voto. Así recupero “intención de voto” para los que no dicen claramente a quién votan pero sí expresan su simpatía.
t_voto <- voto_seguros(muestra)
tabla_seguros(t_voto)| Voto + simpatía | Seguros (%) | No seguros (%) |
|---|---|---|
| PP | 25,2 | 20,8 |
| PSOE | 30,9 | 26,4 |
| VOX | 16,0 | 15,3 |
| SUMAR | 8,2 | 7,2 |
| OTROS | 6,3 | 10,2 |
| BLANCO | 2,2 | 8,2 |
| resto | 11,2 | 11,9 |
Claramente no. Los no seguros votan más en blanco (8,2 % frente a 2,2 %) y más a partidos pequeños, y menos a PP y PSOE.
Además, los no seguros son otra gente: el 30,9 % tiene menos de 35 años (entre los seguros, el 16,5 %), y el 19,9 % se abstuvo el 23-J (frente al 3,2 %). Tiene lógica: quien no fue la última vez suele estar menos seguro de ir esta.
En la tabla, y en todo el post, la variable de voto es voto + simpatía. Muy simple: si no declaras voto pero me dices que, aunque no vayas a votar, tu preferida es Irene Montero, pues te creo y te apunto a Podemos. Así somos, nos creemos la simpatía de la peña. Con eso se ganan bastantes entrevistas. En bruto, sin ponderar nada:
tabla_simpatia(enc)| Casa | Entrevistas | Con voto | Con voto + simpatía | % ganado |
|---|---|---|---|---|
| CIS | 15.540 | 12.473 | 13.893 | 11,4 |
| 40dB | 6.433 | 5.506 | 5.813 | 5,6 |
| More in Common | 4.221 | 3.559 | 3.735 | 4,9 |
| Ateneo del Dato | 1.444 | 1.260 | 1.312 | 4,1 |
| Total | 27.638 | 22.798 | 24.753 | 8,6 |
Visto que los seguros y los dudosos no tienen la misma intención de voto, uno pensaría que basta con meter esta variable en el modelo multinivel de intención de voto. Pero en la parte de la postestratificación hay un problema.
La tabla de postestratificación sale del censo y del 23-J. Tenemos la distribución conjunta poblacional (estimada) por sexo, edad, estudios, provincia y recuerdo de voto. Pero no cuántos de ellos están seguros de ir a votar. Esa información está en las encuestas, pero no en la población.
Pero hay solución: podemos meter en el MRP una variable que no está en la tabla de postestratificación. Hacen falta dos cosas: qué porcentaje de seguros hay en cada celda, y un modelo de voto que tenga en cuenta que los seguros y los dudosos votan diferente.
Para eso está el modelo de participación del (II). Me da, para cada celda \(c\), la proporción de gente que dice “10, seguro que voto” (\(D = 0\)):
\[\pi_c = \text{logit}^{-1}(\eta^\text{part}_c)\]
Pero decir “10” no es votar. Para un escenario de participación \(T\) muevo todos los logit de participación lo mismo, un \(\delta\), hasta que el total cuadra:
\[\pi^\text{cal}_c = \text{logit}^{-1}(\eta^\text{part}_c + \delta), \qquad \text{con } \delta \text{ tal que } \frac{\sum_c N_c\, \pi^\text{cal}_c}{\sum_c N_c} = T\]
O sea, el modelo dice qué celdas tienen más seguros y cuáles menos, y el escenario solo dice cuánto se vota en total. \(\pi^\text{cal}_c\) es la participación de la celda en ese escenario.
Ojo con una cosa. El modelo estima cuánta gente dice 10, no cuánta vota de verdad. En los escenarios supongo que todos los que dicen 10 votan, y que los votantes que faltan salen de los que dicen de 0 a 9. Es un supuesto de la simulación, no algo que digan los datos.
part <- participacion_celdas()
post <- part$post
part_base <- part$part_base

# la tabla de postestratificación tiene ahora dos columnas más: pi y pi_cal.
# Por ejemplo, hombres de 35 a 44 años, estudios bajos, de Madrid, según lo
# que votaron en 2023
madrid_35 <- post |>
  filter(prov == "28", sexo == "H", edad == "35-44", edu == "baja") |>
  select(rec, N, pi, pi_cal_base) |>
  arrange(desc(N))
madrid_35 |>
  mutate(across(c(pi, pi_cal_base), \(x) round(x, 3)), N = round(N))
#>     rec     N    pi pi_cal_base
#> 1    PP 31533 0.734       0.837
#> 2 SUMAR 28953 0.759       0.855
#> 3  ABST 25408 0.169       0.274
#> 4  PSOE 16073 0.700       0.813
#> 5   VOX  9409 0.775       0.865
#> 6 OTROS  3105 0.541       0.687

seguros_pob <- 100 * weighted.mean(post$pi, post$N)
seguros_votantes <- 100 * sum(post$N * post$pi) / sum(post$N * post$pi_cal_base)
En la misma Madrid, mismo sexo, edad y estudios, lo que votaste en 2023 lo cambia todo: los que votaron a PP, PSOE, VOX o SUMAR dicen “10” en un 70 % o más; los que se abstuvieron, en un 17 %.
En toda España, el 60,6 % de la población dice “10”. Con una participación del 70,4 %, el 86,0 % de los votantes son seguros y el resto, no seguros. Y como la participación de cualquier escenario que miro está por encima de ese 60,6 %, en cada celda \(\pi^\text{cal}_c \geq \pi_c\): caben todos los seguros y sobra sitio para algunos no seguros.
En resumen, si en una celda el 20 % son seguros pero, tras subir la participación de España hasta un escenario propuesto (digamos el 80 %), esa celda pasa a votar el 30 %, esos 10 puntos adicionales los pongo con dudosos, y su voto sale del modelo que tiene en cuenta esa variable. Así, si en un perfil el modelo de voto dice que los dudosos votan mucho más a Frente Amplio que los seguros, en ese escenario habría en ese perfil bastantes más votos a Frente Amplio.
El modelo de voto es el del (II), multinomial con efectos de casa, mes, edad, estudios, recuerdo, CCAA y provincia, pero tras analizar los efectos aleatorios le quité la interacción entre CCAA y recuerdo de voto: metía muchos parámetros a estimar sin una mejora acorde. Le añado la variable \(D\) (dudoso): 1 si el entrevistado dice cualquier cosa menos 10, 0 si dice 10. Ojo, es la \(D\) que sale de lo que contesta cada entrevistado, no la probabilidad que estima el modelo de participación. Los dos modelos se ajustan por separado y solo se juntan al postestratificar.
\[\mathbf{y}_c \sim \text{Multinomial}\big(n_c,\ \text{softmax}(\boldsymbol\eta_c + D_c\, \mathbf{d}_c)\big)\]
\[d_{c,k} = b^\text{dud}_k + a^\text{dud, edad}_{\text{edad}[c],\,k} + a^\text{dud, recuerdo}_{\text{rec}[c],\,k}\]
Es decir, \(d_{c,k}\) es cuánto se mueve el logit del partido \(k\) en la celda \(c\) si la persona es dudosa (\(D_c = 1\)). Si es segura, \(D_c = 0\) y el término desaparece. Depende de la celda solo por su edad y por lo que votó en 2023: dos celdas con la misma edad y el mismo recuerdo tienen el mismo \(d\). No tiene por qué ser lo mismo no estar seguro a los 20 que a los 70, ni haber votado al PP que haberse abstenido. Con pooling parcial, claro. El código en Stan está en mrp_voto_seg.stan.
Con esto, para cada celda tengo dos repartos de voto: \(P(k \mid c, D=0)\), prediciendo con \(D = 0\), y \(P(k \mid c, D=1)\), prediciendo con \(D = 1\).
Antes de la fórmula, una celda ficticia. La tabla de postestratificación dice que en esa celda ficticia hay 1.000 personas, y el modelo de participación estima que el 40 % está seguro de ir a votar. O sea, 400 seguros y 600 no seguros.
Ahora digo que en esa celda vota el 70 %: 700 votantes. Supongo que los 400 seguros votan todos, así que los otros 300 votantes salen de los 600 no seguros.
Para un partido cualquiera, el modelo de voto dice que lo vota el 30 % de los seguros (prediciendo con \(D = 0\)) y el 20 % de los no seguros (con \(D = 1\)). Pues:
Y ya está. Con letras, para la celda \(c\) y el partido \(k\):
\[V_{c,k} = N_c \Big[\pi_c\, P(k \mid c, D=0) + (\pi^\text{cal}_c - \pi_c)\, P(k \mid c, D=1)\Big]\]
\(N_c\) es la gente de la celda (los 1.000), \(\pi_c\) la proporción de seguros que estima el modelo de participación (el 40 %) y \(\pi^\text{cal}_c\) la participación de la celda en el escenario (el 70 %). \(N_c\,\pi_c\) son los 400 y \(N_c\,(\pi^\text{cal}_c - \pi_c)\), los 300.
Aquí he puesto el 70 % a mano, para esa celda. En el análisis de verdad no fijo la participación de cada celda, fijo la de España, y la de cada celda sale de mover todos los logit lo mismo, el \(\delta\) de antes. Así que cada celda acaba con su propia \(\pi^\text{cal}_c\).
Luego, en cada draw de la posteriori, se suman en cada provincia los votos a cada partido de todas las celdas de esa provincia y se aplica D’Hondt (teniendo en cuenta las coaliciones, y cosas como lo de Adelante Andalucía).
Este truco de meter en el MRP una variable que no está en el censo no me lo he inventado yo, se denomina MRP con variables no censales (Kastellec et al. 2015; Lopez-Martin et al. 2022).
Lo bueno es que, si sube la participación, la parte de los seguros no se mueve y solo crece la de los no seguros. Así que lo que importa es cómo votan los no seguros de cada celda, y no la media de la celda.
Una de las ventajas de usar multinivel es su estimación en dominios pequeños gracias al partial pooling, permitiendo estimaciones incluso en niveles no vistos por el modelo. La postestratificación en el MRP también permite dar estimaciones en combinaciones de celdas no vistas por el modelo. Un ejemplo:
Hombres de 35 a 44 años, estudios bajos, de Madrid, que se abstuvieron en 2023.
celda <- post |>
  filter(
    sexo == "H",
    edad == "35-44",
    edu == "baja",
    rec == "ABST",
    prov == "28"
  )
celda
#>   sexo  edad  edu  rec   ccaa prov        N        pi pi_cal_base pi_cal_80
#> 1    H 35-44 baja ABST Madrid   28 25407.77 0.1687316   0.2739802 0.4354793

# entrevistas con ese perfil, en Madrid y en toda España
perfil <- muestra |>
  filter(sexo == "H", edad == "35-44", edu == "baja", rec == "ABST")
n_perfil <- nrow(perfil)
n_celda <- sum(perfil$prov %in% 28)
Son 25.408 personas y en las encuestas hay 0 entrevistas de esa celda. En toda España, con ese perfil, hay 29 entrevistados.
Pero el modelo puede dar estimaciones para ese perfil en Madrid.
Primero, cuántos votan. El modelo de participación dice que en esta celda \(\pi_c\) = 16,9 % dicen “10”, así que 25.408 × 16,9 % = 4.287 seguros. Con la participación base, la celda vota un \(\pi^\text{cal}_c\) = 27,4 %, y los no seguros ponen el resto: 25.408 × (27,4 % − 16,9 %) = 2.674.
¿Y de dónde sale ese 27,4 %? A mano no lo he puesto. En toda España dice “10” un 60,6 %, y queremos que vote un 70,4 %. Así que a todas las celdas se les suma lo mismo en el logit, el \(\delta\) de antes. Ese \(\delta\) no lo estima el modelo, lo calculo yo después: para cada draw de la posterior del modelo de participación busco el \(\delta\) que hace que el total de España salga 70,4 %. Así que hay un \(\delta\) por draw; su mediana es 0,62 y el 90 % está entre 0,56 y 0,68. En esta celda eso lleva a los que votan del 16,9 % al 27,4 %. La celda no se ajusta para dar nada en concreto: sube lo que le toca para que, sumando todas, salga el 70,4 % de España.
Poca participación, como era de esperar en gente que se abstuvo la última vez.
Y la mediana de la posterior para esa celda y para ese escenario de participación:
ej <- ejemplo_celda(celda, part$mes)
tabla_celda(ej, part_base)| Votantes |
Voto (%)
|
|||||
|---|---|---|---|---|---|---|
| PP | PSOE | VOX | SUMAR | BLANCO | ||
| Seguros | 4.287 | 24,7 | 13,1 | 44,3 | 2,8 | 3,7 |
| No seguros que votan | 2.674 | 19,3 | 17,1 | 31,6 | 4,1 | 12,8 |
| La celda (suma) | 6.961 | 22,7 | 14,6 | 39,5 | 3,3 | 7,2 |
Lo mismo en un gráfico. Arriba, cómo se reparte la gente de la celda entre los seguros, los no seguros que acaban votando y los que no votan. Abajo, a quién vota cada una de las dos partes, ya con todos los partidos. Ojo, son estimaciones del modelo, no votos observados (en esta celda no hay ni una entrevista), y los porcentajes de voto son resúmenes de la posterior: la mediana y el intervalo del 90 %.
Por cierto, en esta celda se ve bien una de las ventajas del MRP frente a ponderar directamente las entrevistas, por ejemplo con raking. Con ponderación podemos corregir la composición de la muestra, pero no podemos dar peso a una entrevista que no existe. Aquí no tenemos ni una entrevista de ese perfil en Madrid y, sin embargo, el modelo multinivel puede estimar su comportamiento aprovechando la información de otros perfiles. Después, la postestratificación permite aplicar esa estimación a las 25.408 personas de la celda.
grafico_celda(ej, part_base)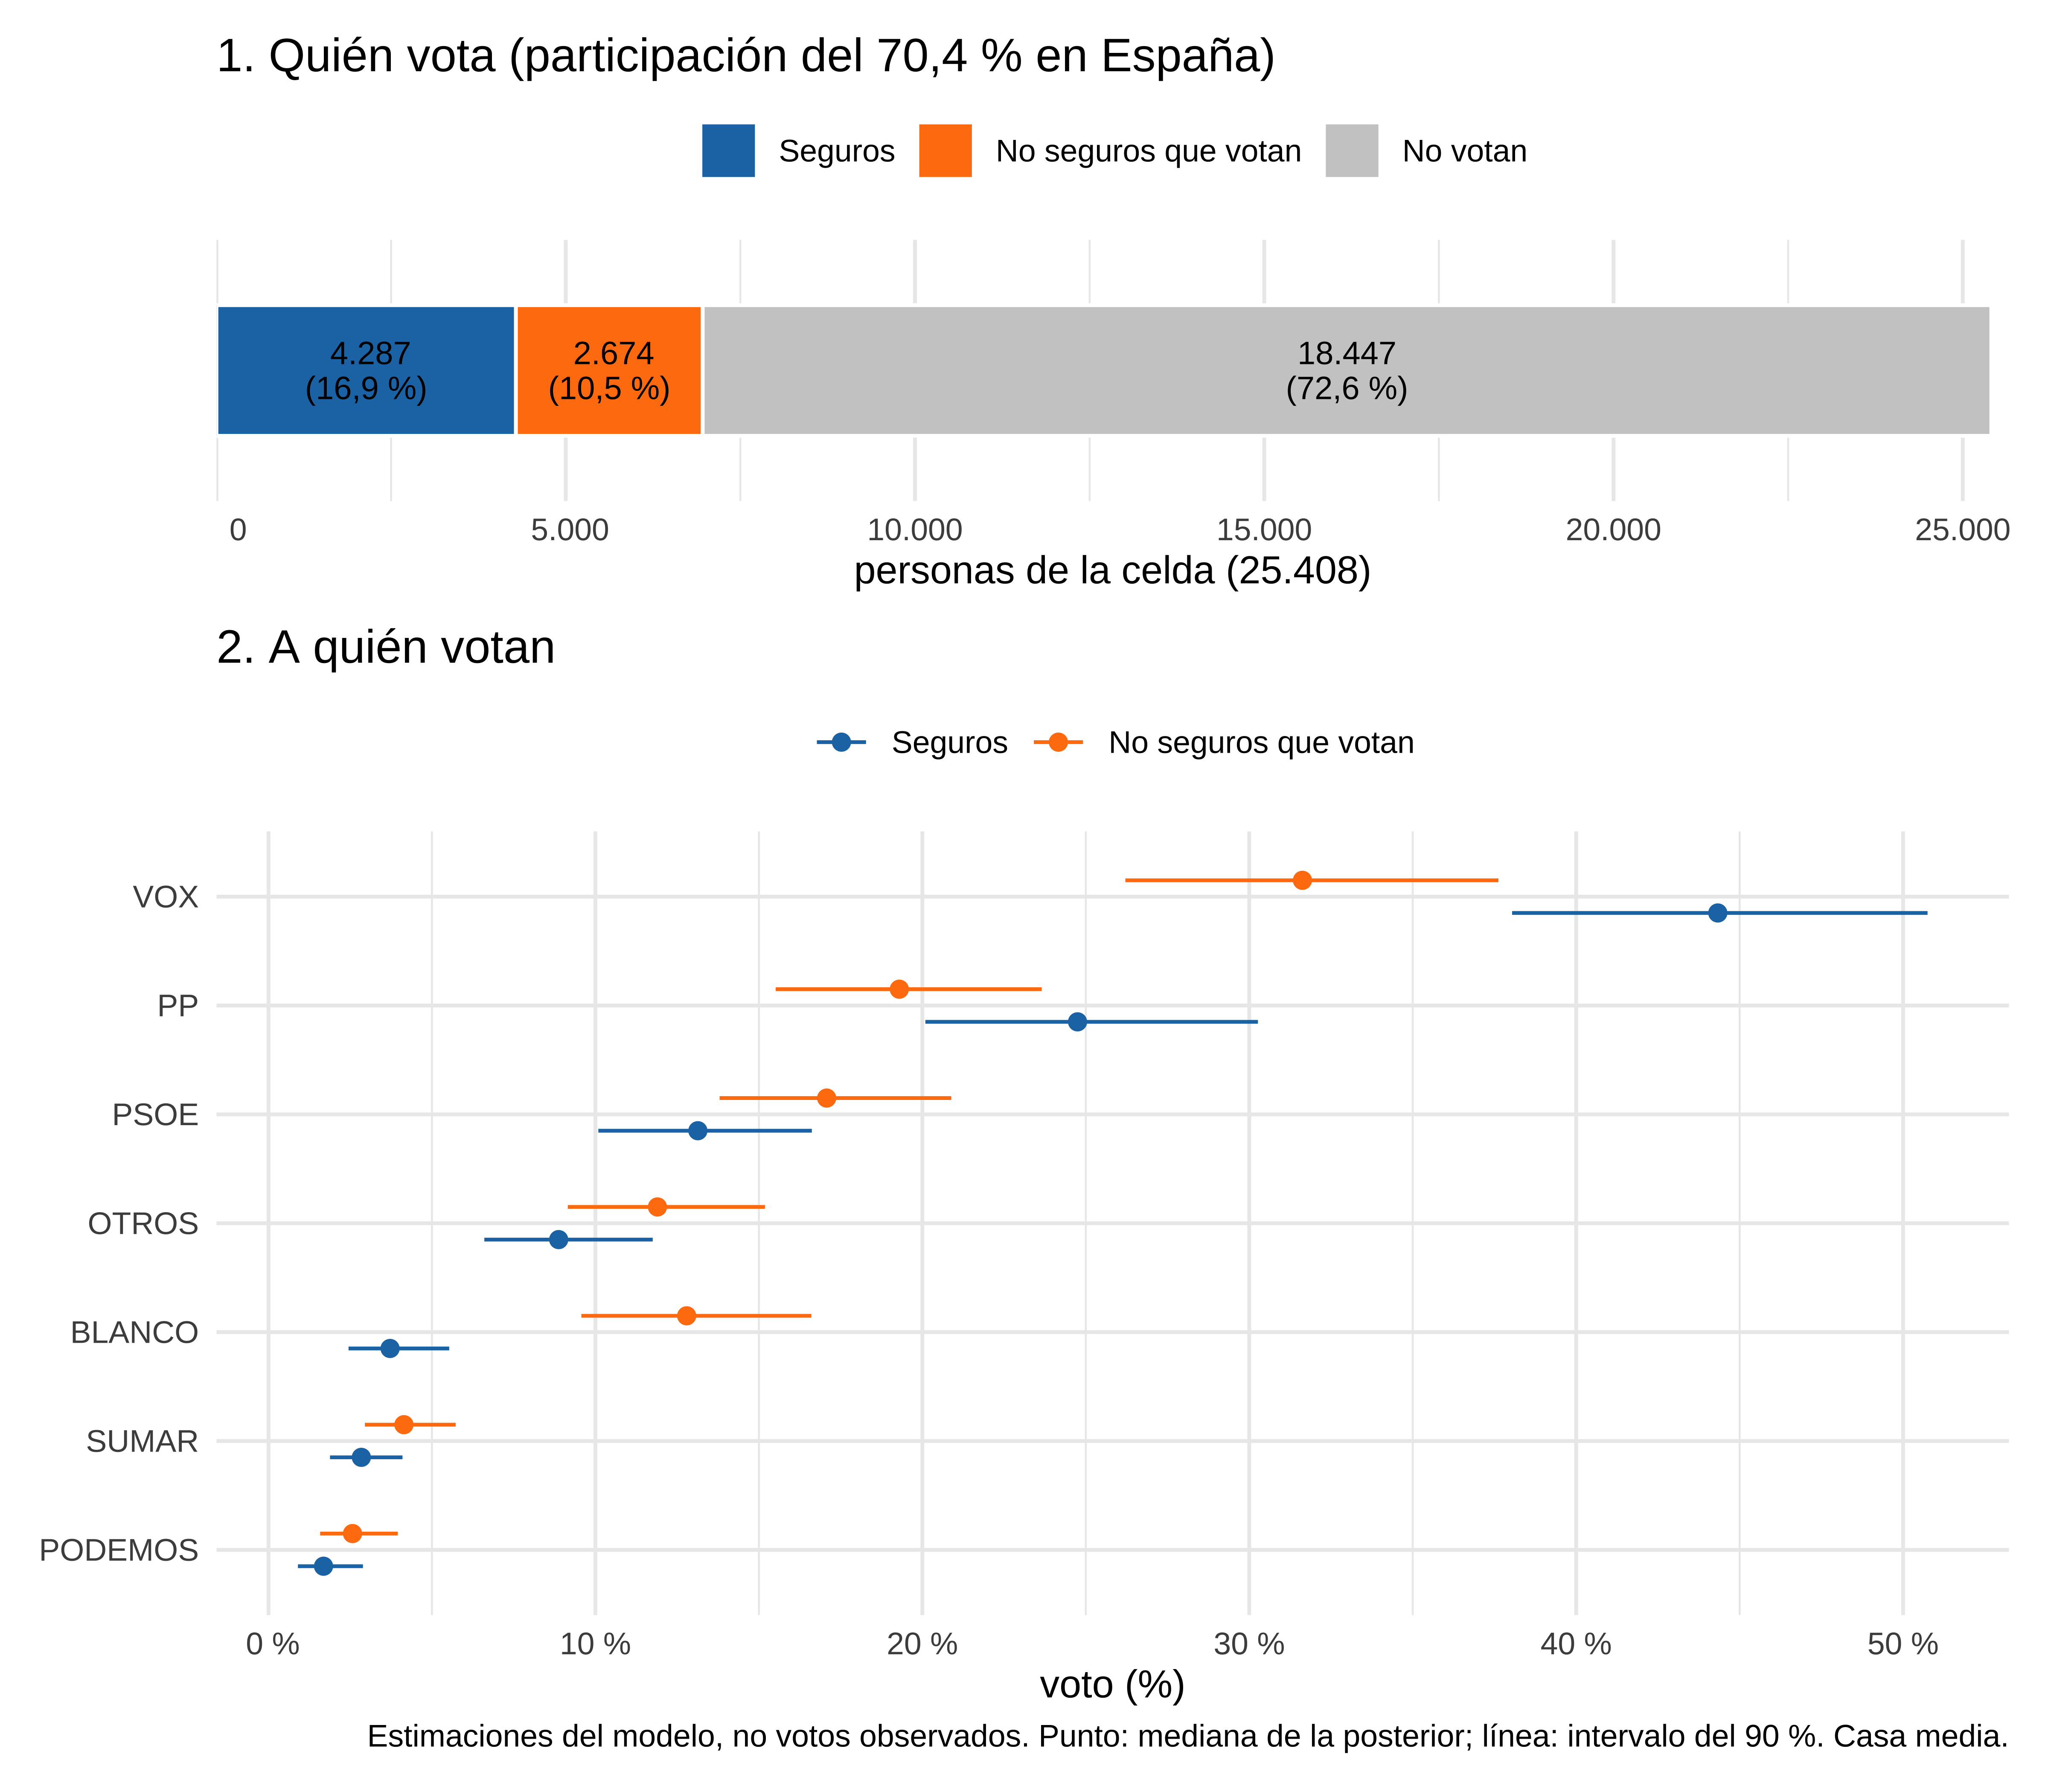
Si aumentara aún más la participación, en esta celda subiría el porcentaje de voto en blanco y bajaría el de VOX. En número de votos VOX seguiría sumando, solo que menos que su media en la celda.
Vale, ya tenemos el mecanismo, vamos a usarlo a ver si cambia algo.
Repito de nuevo, no es lo que pasaría si vota más gente, es lo que sale si los que se suman son los no seguros de cada celda y votan como dicen en la encuesta.
esc <- leer_escenarios(part_base)
grafico_escenarios(esc$mayorias)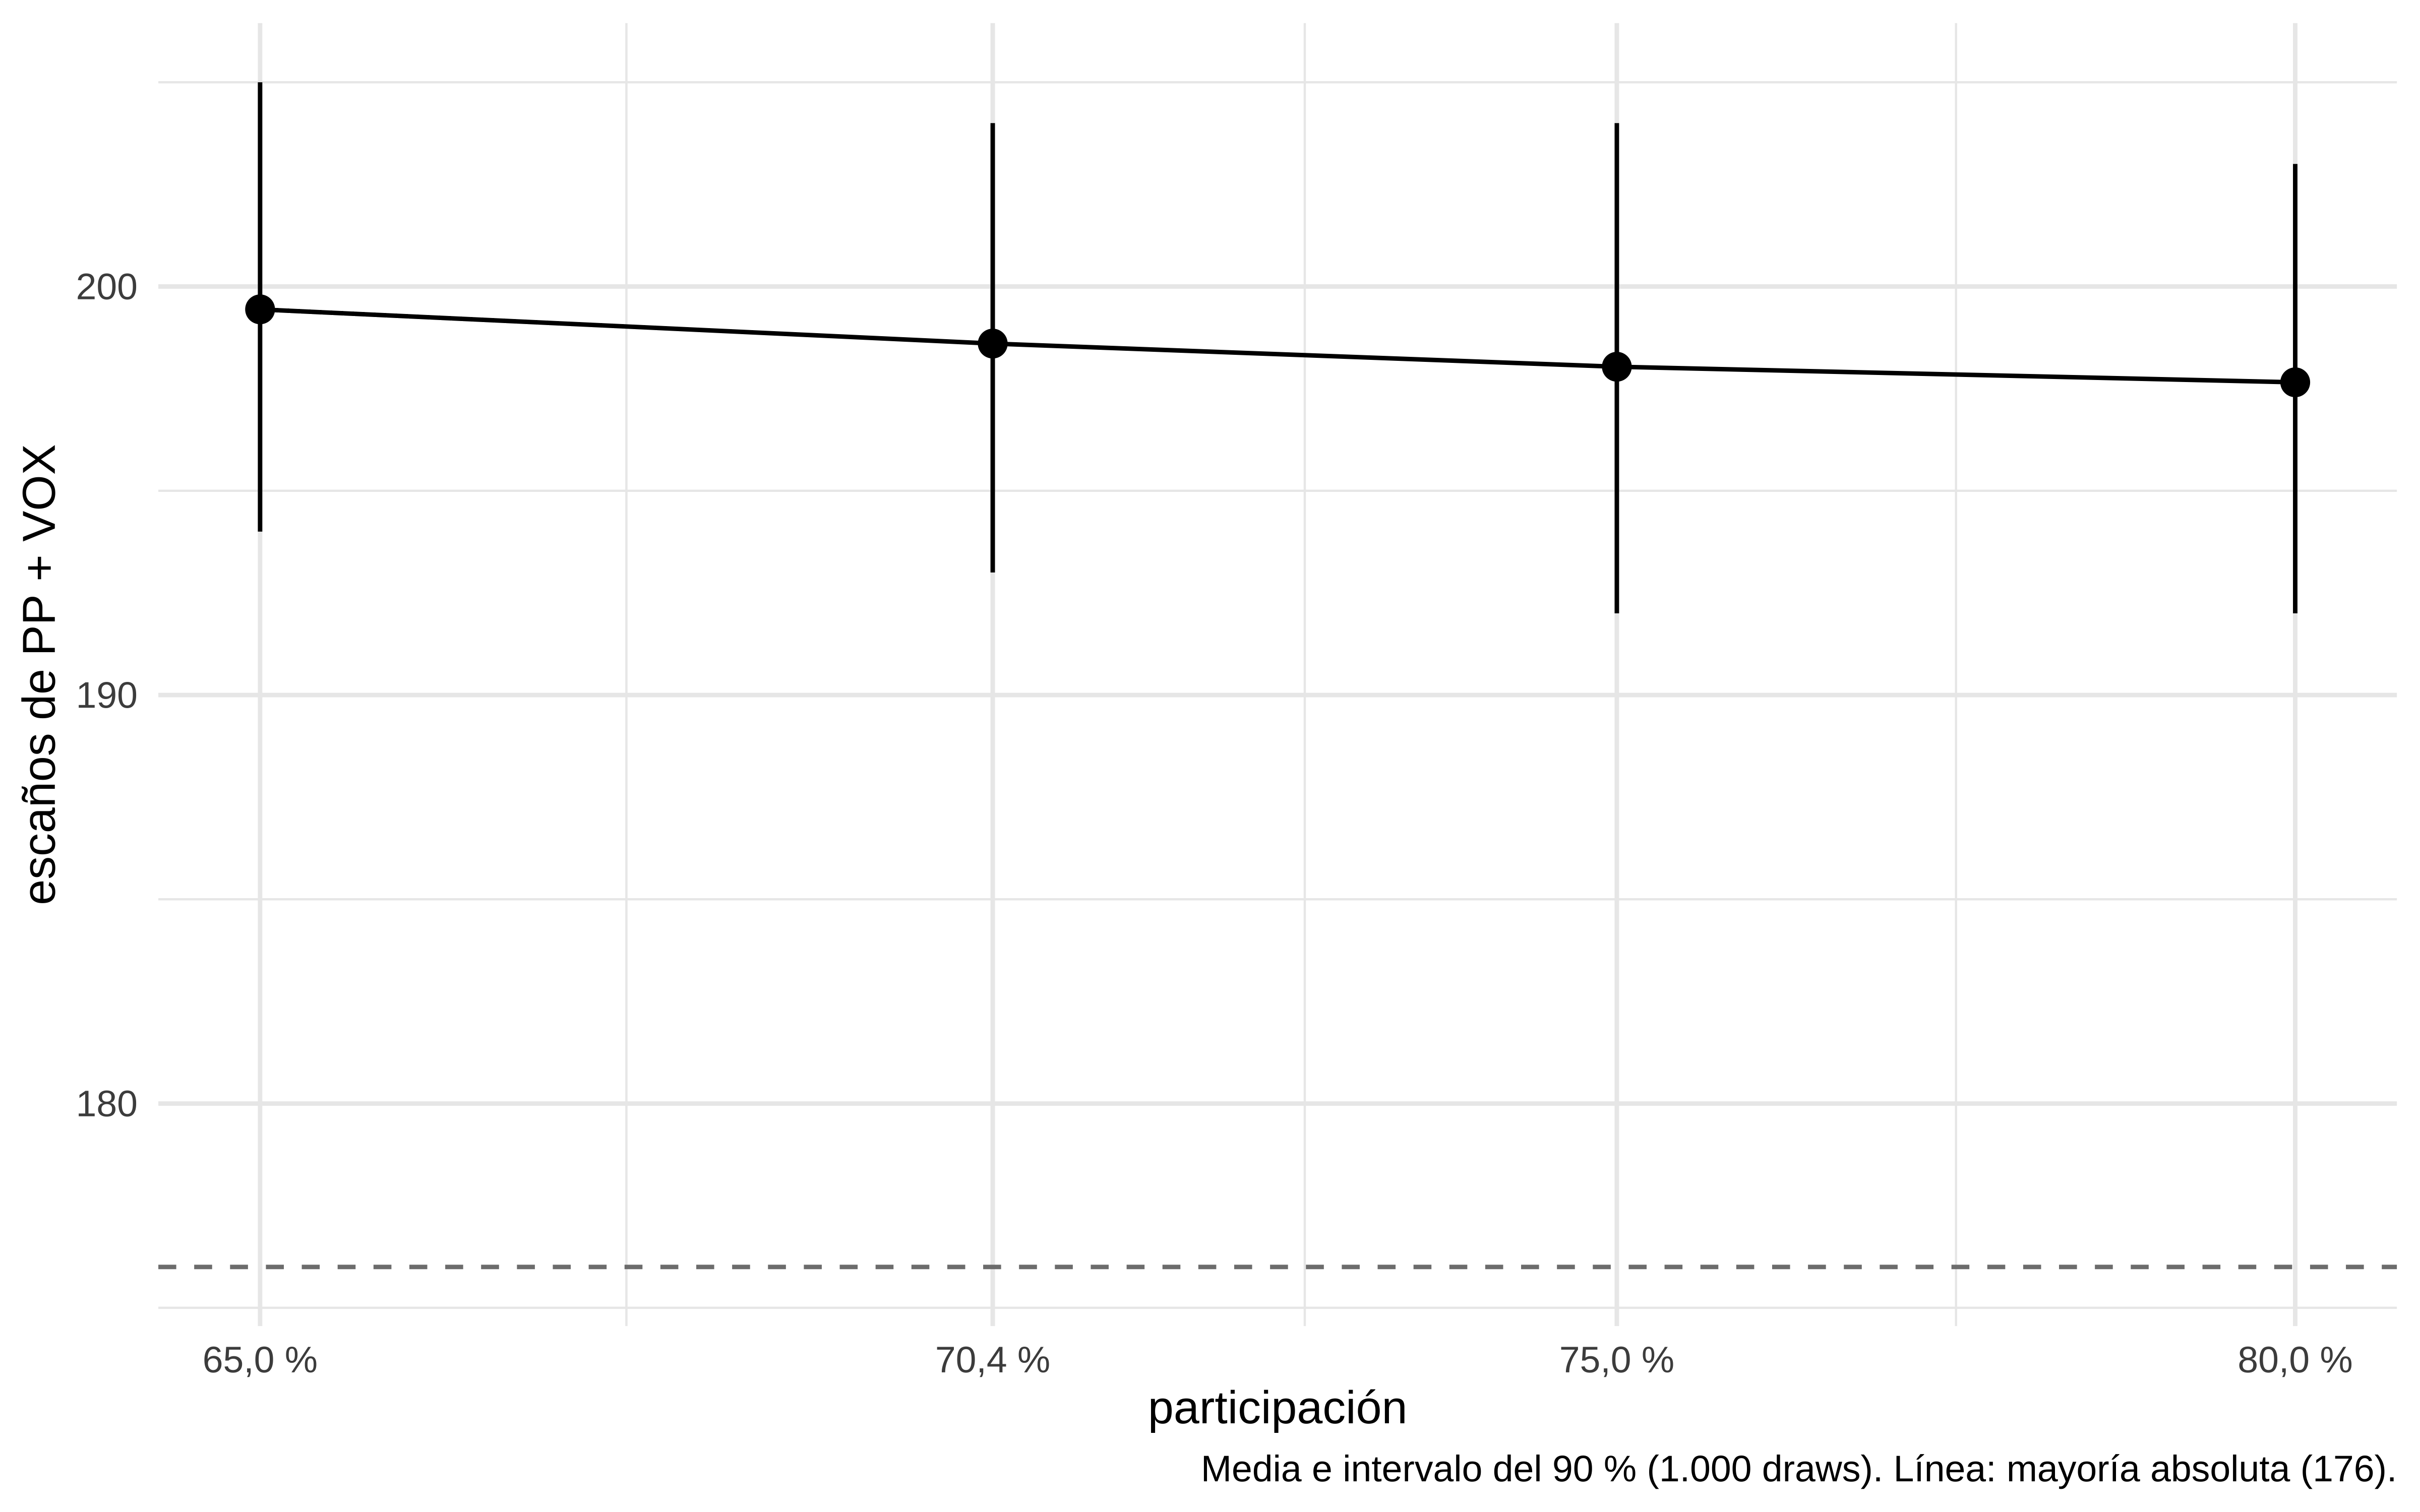
Pues nuestro gozo en un pozo, apenas se mueve nada con estos supuestos. Del 65,0 % al 80,0 % de participación, PP + VOX pasa de 199,4 a 197,7 escaños. Y la mayoría absoluta (176) la tienen en todos los escenarios.
¿Por qué se mueve tan poco? Así votan los que se suman al pasar del 70,4 % al 80 %:
tabla_entrantes(esc$entrantes)| Partido | Mediana (%) | p5 (%) | p95 (%) |
|---|---|---|---|
| PSOE | 23,9 | 22,2 | 25,6 |
| PP | 20,7 | 19,3 | 22,2 |
| VOX | 18,5 | 17,0 | 20,4 |
| OTROS | 10,9 | 9,7 | 12,2 |
| BLANCO | 8,9 | 7,6 | 10,2 |
| SUMAR | 6,1 | 5,4 | 6,9 |
| PODEMOS | 2,7 | 2,2 | 3,2 |
| ERC | 2,4 | 2,0 | 2,9 |
| JUNTS | 1,6 | 1,2 | 2,1 |
| BILDU | 1,1 | 0,9 | 1,4 |
| PNV | 0,8 | 0,6 | 1,1 |
| AA | 0,8 | 0,4 | 1,4 |
| BNG | 0,6 | 0,4 | 0,8 |
| CCA | 0,5 | 0,3 | 0,7 |
| UPN | 0,2 | 0,1 | 0,3 |
Entre los que entran con un escenario del 80 %, PP + VOX suman un 39,2 %, menos que el 47,6 % que tienen con la participación base. Así que sí, entre los que entran (los dudosos) PP y VOX pesan menos. Ojo, esto es en porcentaje: en número de votos PP y VOX también suben, solo que menos que el resto. Y los que entran son pocos al lado de los que ya votaban: al 80 %, algo más de uno de cada diez votantes.
Además, por lo que declaran en la encuesta los no seguros, un 19,8 % de los que entran va a OTROS o en blanco, frente al 8,6 % en el escenario base. En nuestro reparto ni BLANCO ni OTROS (que junta los partidos que no modelizo por separado) compiten por escaños. Así que una parte del voto nuevo no se lleva escaños de nadie. A eso se suma que los escaños se reparten provincia a provincia, y unos pocos votos más o menos no siempre mueven un escaño. No he medido cuánto pesa cada cosa por separado, así que tómalo como una explicación posible, no como algo demostrado.
Y repito: no sabemos si los dudosos que contestan a las encuestas votarían como los que de verdad acabarían yendo a votar.
¿Y si no hubiera metido seguros y no seguros en el modelo de voto? Sería como suponer que todo el que vota en una celda, entre o no entre, vota como la media de su celda. Eso se puede calcular con el mismo modelo, mezclando en cada celda el voto de seguros y dudosos según cuántos seguros hay entre los que dan partido. No es un modelo ajustado sin la variable, es una aproximación. Con eso, PP + VOX tendrían 195,1 escaños con la participación base (frente a 198,6) y 195,6 al 80 % (frente a 197,7). Ya en la base hay diferencia, porque también ahí parte de los votantes son no seguros. Y al subir la participación, sin la variable PP + VOX suben un pelín y con ella bajan un pelín. Pero son unos pocos escaños, con intervalos que se solapan (del 190 al 201 sin la variable y del 193 al 204 con ella, en la base).
Después de todo el lío, con estos supuestos, subir la participación apenas cambia el reparto de escaños. Pero por el camino hemos metido en el MRP una variable que no está en la tabla de postestratificación, y hemos podido modelizar que seguros y dudosos no votan igual. Y eso vale para otras cosas.
Ya que tenemos el modelo ajustado, dejo aquí las estimaciones nacionales y provinciales, también por edad, para quien quiera curiosear. Hay dos escenarios de participación nacional: el 70,4 % (la base) y el 80 %. Se pueden filtrar y descargar en CSV o Excel; la descarga se lleva todas las filas que pasan los filtros, no solo la página que se ve. La fila “Diferencia” es el 80 % menos la base, calculada draw a draw (en puntos para el voto). Son estimaciones condicionadas a los supuestos del modelo, no resultados electorales garantizados: los intervalos (del 90 %) recogen la incertidumbre de este MRP, pero no el error común de las encuestadoras del post de metaanálisis bayesiano.
tabla_dt(
  anexo$nacional,
  c(et_voto, setNames(et_esc, paste0("esc_", names(et_esc)))),
  c(
    mediana = 1,
    p5 = 1,
    p95 = 1,
    esc_media = 1,
    esc_mediana = 0,
    esc_p5 = 0,
    esc_p95 = 0
  ),
  "mrp_iii_nacional"
)tabla_dt(
anexo$voto_prov,
et_voto,
c(mediana = 1, p5 = 1, p95 = 1),
"mrp_iii_voto_provincia"
)tabla_dt(
anexo$escanos_prov,
et_esc,
c(media = 2, mediana = 0, p5 = 0, p95 = 0),
"mrp_iii_escanos_provincia"
)tabla_dt(
anexo$voto_prov_edad,
et_voto,
c(mediana = 1, p5 = 1, p95 = 1),
"mrp_iii_voto_provincia_edad"
)Desde la raíz del repo; los datos están en la release (bash 2026/11/mrp-multiencuesta/completo/baja_datos.sh).
| Script | Qué hace |
|---|---|
iii-funciones.R |
las funciones que llama este post |
completo/10_datos_voto_seg.R |
datos del modelo de voto con seguro / no seguro |
completo/11_ajusta_voto_seg.R |
el ajuste en Stan (mrp_voto_seg.stan) |
completo/12_escenarios_voto_seg.R |
escenarios de participación y escaños |
completo/17_votos_grupos.R |
votos por grupos (votos_grupos.rds) |
completo/18_seg_dud_provincia.R |
voto seguro y dudoso por provincia y el mapa (seg_dud_prov.rds, provincias_sf.rds) |
completo/19_anexo_tablas.R |
las tablas del anexo (nacional, provincia y provincia × edad) |